# Integrador: Da Instabilidade à Arquitetura de Microsserviços
> Neste post detalho a jornada de construção de um dos projetos mais complexos que já trabalhei, migrando de um sistema instável para uma arquitetura resiliente.
- Por: Antônio Miranda (https://antmiranda.dev)
- Publicado em: 12 de dezembro de 2025
- URL: https://antmiranda.dev/pt-br/blog/in-depht/integrador
- Tags: projetos, desenvolvimento, post-mortem, backend, arquitetura, microservices, nestjs
## Qual a dor que o projeto resolve?
Desde que assumi a área de desenvolvimento do TCS [Terminal de Cargas de Sarzedo](https://tcsmg.com.br/), vínhamos enfrentando problemas quase "agendados" no sistema de integração de notas fiscais com os clientes.
Ao menos uma vez por mês, tínhamos uma instabilidade severa ou parada total no sistema. Isso impactava diretamente a operação do terminal, levando horas, ou até dias para conseguirmos restabelecer o funcionamento normal.
## Proposta inicial
Diante desse cenário, comecei a arquitetar uma solução. Inicialmente, tentei manter a base do sistema existente, mas separando as três partes críticas:
1. **Ingestão:** Leitura da caixa de entrada de e-mail e processamento de anexos XML;
2. **Tratamento:** Processamento e formatação dos dados para o sistema interno operacional;
3. **Integração:** Comunicação ativa com os sistemas dos clientes.
Entretanto, isso rapidamente se provou inviável. A arquitetura legada não comportava essa separação de forma eficiente. Insistir em um monolito, com varias outras funções além da integração, para esse tipo de processamento seria um erro; criar um "braço" do monolito para cada novo cliente tornaria a manutenção um pesadelo de complexidade ciclopica.
## O Ponto de Virada
Em 28 de Agosto de 2025, houve a quebra definitiva. O sistema parou totalmente.
Naquele momento, ainda não tínhamos a solução pronta, embora eu já viesse me preparando mentalmente para esse dia. Após algumas horas de tensão, consegui colocar o sistema no ar de forma precária, mas suficiente para apagar o incêndio imediato.
Já com a solução idealizada, comecei os trabalhos. No dia 2 de setembro de 2025, a diretoria reuniu o setor e nos deu o ultimato: precisávamos resolver o problema pela raiz.
Com o apoio total do setor de TI e do Gerente Operacional, interrompi o trabalho em todos os outros projetos, congelando o backlog, e mergulhei exclusivamente na construção da solução definitiva.
## Arquitetura
Optei por uma arquitetura baseada em microsserviços utilizando **NestJS Microservices**. O objetivo era ter responsabilidades extremamente bem definidas, eliminando o acoplamento.
Para a comunicação assíncrona e resiliência, adotei o **RabbitMQ**. Isso garante que, se uma ponta do sistema cair, as mensagens fiquem enfileiradas e nada se perca.
A arquitetura principal foi dividida em dois núcleos:
- **Nfe Service:** Leitura de e-mail e processamento bruto de XML;
- **Operacional Service:** Formatação e envio para o sistema interno.
Além disso, adotamos uma estratégia de isolamento para os clientes: cada cliente possui seu próprio microsserviço dedicado.
Para otimizar o desenvolvimento, criei microsserviços base (ex: `XMINING-basic`), contendo o código essencial para integrações repetitivas, permitindo reutilização rápida para clientes que usam o mesmo ERP.
### Leitura de E-mail e Processamento (Nfe Service)
Este microsserviço monitora a caixa de entrada do Outlook em tempo real. Ele gerencia automaticamente as pastas, processa anexos de forma assíncrona e garante que o fluxo não trave, independentemente do volume de entrada.
Implementamos também uma camada de inteligência: identificação automática de e-mails ou clientes inválidos, com classificação e rejeição automática. Esses dados são armazenados para futuro treinamento de modelos de Machine Learning. O objetivo é blindar o sistema: não importa se o layout do XML da receita mudar ou se chegar lixo, o sistema saberá lidar.
### Processamento para o Operacional (Operacional Service)
Este é o coração da tradução de dados. Ele recebe inputs tanto dos microsserviços dos clientes quanto do *Nfe Service* e converte tudo para o formato do **OpenGTM** (sistema terceiro utilizado pelo operacional).
À primeira vista parece simples, mas a complexidade é alta. O OpenGTM possui uma estrutura rígida baseada em SOAP, mas feita via requisições JSON com formatação extremamente específica. Um erro de vírgula ou tipo de dado resulta em recusa.
Infelizmente, por questões de *compliance*, não posso compartilhar o código, mas foi um desafio de engenharia e estruturação de dados muito interessante de resolver.
### Microsserviços de Clientes
A filosofia aqui é o isolamento de falhas. Desde que o sistema do cliente tenha um endpoint que retorne os dados que o TCS precisa, ele ganha um microsserviço próprio.
Isso garante que, se o sistema do "Cliente A" sair do ar, o "Cliente B" e o resto do Integrador continuam operando normalmente.
Esses serviços contam com primitivos básicos padronizados:
- Fila de envio e retentativas;
- CRUD de dados de integração;
- Monitoramento de status.
Quando chega um novo cliente, basta "clonar" a estrutura dos primitivos básicos e ajustar a regra de negócio específica.
### Sistema de Monitoramento
Sair do escuro era uma prioridade. O sistema conta com um microsserviço de monitoramento que despacha alertas baseados no escopo:
- **Erros de código/infra:** Notificam diretamente a mim e ao time de TI.
- **Erros de negócio:** Notificam os operadores em tempo real (ex: nota fiscal sem veiculo vinculado).
#### Prometheus e Grafana
Implementamos métricas detalhadas para observabilidade:
- Saúde geral do fluxo do Integrador;
- Consumo de recursos (CPU/RAM) por contêiner;
- Estatísticas de sucesso/falha na integração com o OpenGTM;
- Throughput de cada microsserviço e cliente.
## Frontend
A interface visual foi dividida em duas frentes estratégicas:
### 1. Módulo no SIG (Sistema Integrado de Gestão)
O SIG é o nosso "super-app" corporativo que unificou diversos subsistemas legados. (Merecedor de um post proprio e breve) O Integrador ganhou seu próprio módulo dentro dele com duas telas principais:
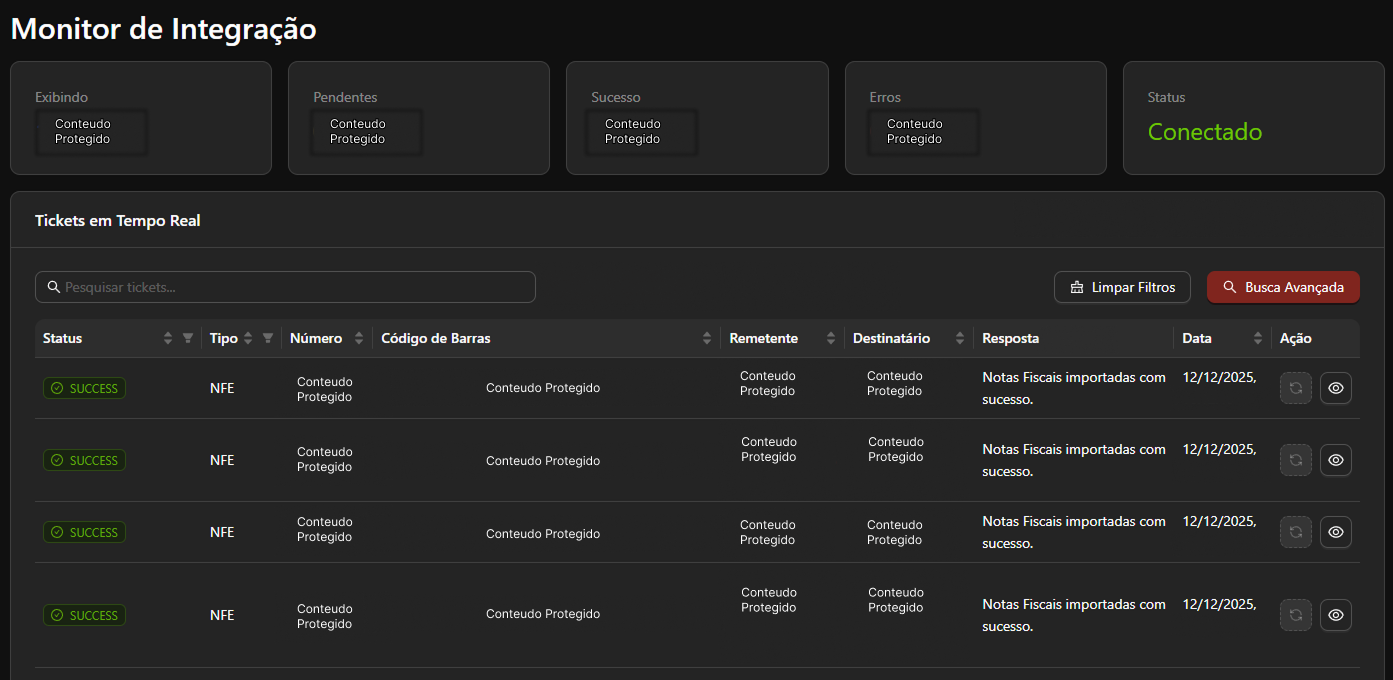
**Tela 1: Monitor de Integração**
Utilizada pelos operadores (balanceiros) para acompanhar o fluxo em tempo real: código de barras, data, status e logs de erro amigáveis.
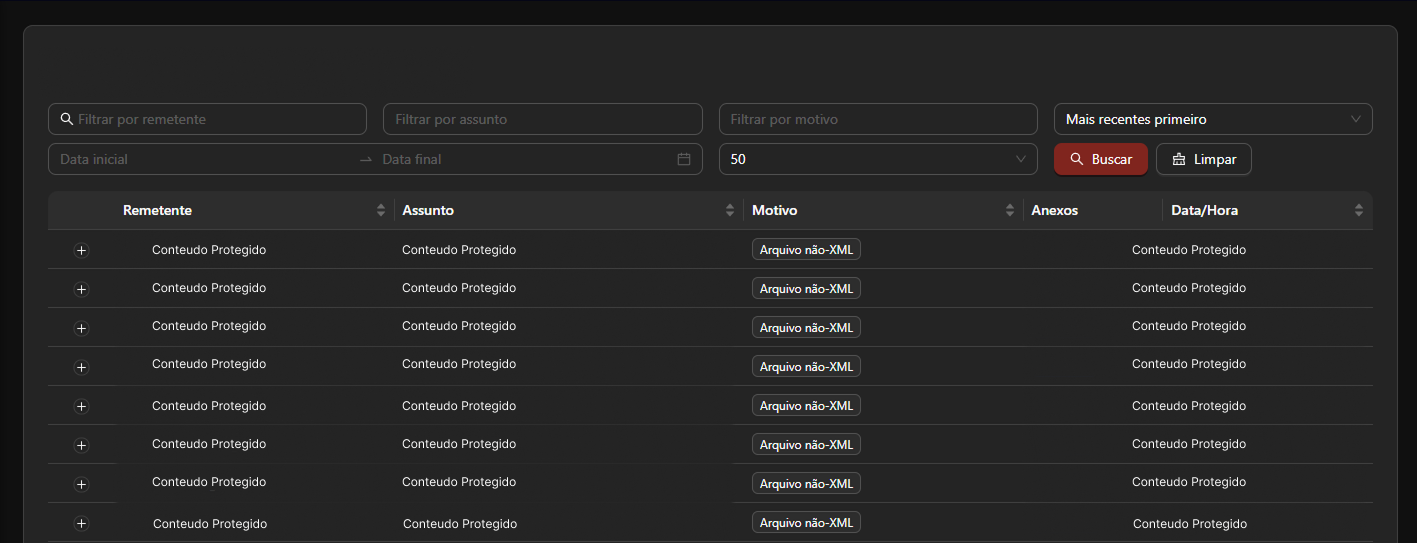
 **Tela 2: E-mails Inválidos**
Permite que a operação veja o que foi rejeitado automaticamente e o motivo.
 ### 2. Portal do Cliente
Um projeto separado (ainda em construção) onde os próprios clientes poderão acompanhar seus processos de integração, reduzindo a carga de suporte sobre o nosso time.
## Implantação e DevOps
A virada de chave oficial ocorreu dia **12 de setembro de 2025**. Aposentamos o sistema antigo e migramos 100% do fluxo.
Para gerenciar essa complexidade, adotei uma estratégia de **Monorepo**. O nosso CI é inteligente: detecta quais pastas/serviços foram alterados e executa builds e testes apenas nas partes afetadas, otimizando drasticamente o tempo de deploy. Seguindo padrões de mercado.
## Benefícios Conquistados
A mudança de arquitetura trouxe ganhos tangíveis:
* **Isolamento de Falhas:** Um erro em um módulo não derruba o sistema inteiro.
* **Redução de Custos:** Menor complexidade de manutenção e correções mais rápidas significam menos horas-homem gastas em "apagar incêndios" e menos horas de operação parada.
* **Alta Performance:** O processamento assíncrono permite lidar com picos de carga sem gargalos.
* **Escalabilidade Horizontal:** O que antes era estático, agora escala dinamicamente conforme a demanda.
* **Observabilidade:** Antes voávamos no escuro; agora temos um cockpit completo com métricas e dashboards.
## Crescimento Pessoal
Trabalhar nesse projeto de forma tão intensa nesses últimos 3 meses foi uma imersão técnica. Pude colocar em prática conceitos avançados de sistemas distribuídos e arquitetura de software que vinha estudando, saindo da teoria para a "guerra" da produção.
Especialmente por ter que colocar um sistema tão complexo e distribuido em produção sem poder testar exaustivamente cada parte do sistema.
## Conclusão
Hoje, completamos exatamente 3 meses desde o "ponto de virada". O sistema está estável, tendo passado por apenas duas interrupções planejadas para manutenção programada.
Problemas como "Erro na integração com Cliente X" ainda ocorrem, mas agora são exceções tratadas, isoladas e esperadas dentro da arquitetura, sem parar a operação da empresa.
Foi, sem dúvidas, uma das experiências mais desafiadoras e gratificantes da minha carreira até agora. Agradeço imensamente ao setor de TI pela cobertura e suporte durante esse período de foco total.
O projeto não acabou. Pelo contrário, agora ele está pronto para evoluir.